الصين تطلق DeepSeek-V3.1: ثورة جديدة في عالم الذكاء الاصطناعي بتكلفة منخفضة
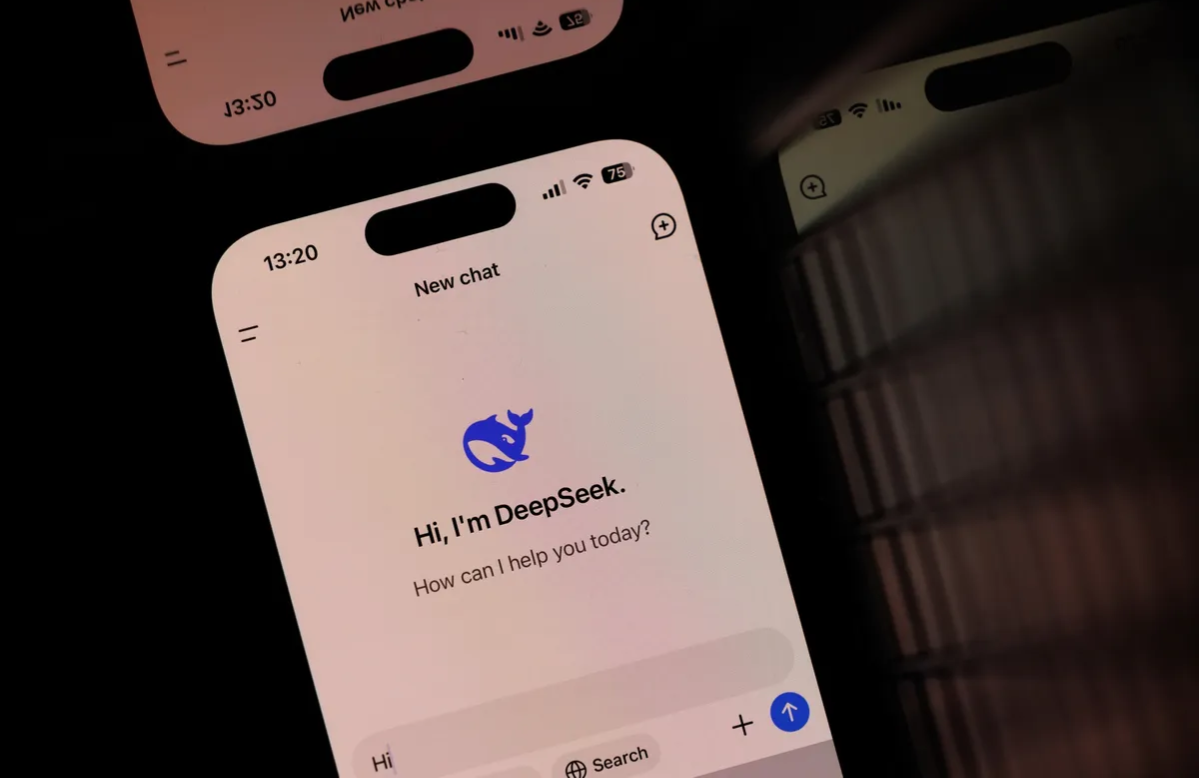
أعلنت الشركة الصينية DeepSeek عن إطلاق النسخة الجديدة من نموذج الذكاء الاصطناعي الخاص بها DeepSeek-V3.1، والذي يُعد تطوراً كبيراً في مجال النماذج اللغوية الكبيرة (LLMs) من حيث الأداء والكفاءة والتكلفة.
النموذج الجديد، الذي تم تدريبه على 14.8 تريليون رمز (token) من البيانات عالية الجودة، يضم 560 مليار معلمة، مع تفعيل 37 مليار معلمة فقط لكل رمز معالَج، مما يجعله أحد أكثر النماذج كفاءة في استهلاك الموارد الحاسوبية.
يتميز DeepSeek-V3.1 بتحسينات كبيرة في الدقة والاستدلال متعدد الخطوات، مع تقليل نسبة “الهلوسة” (المعلومات غير الدقيقة) بنسبة 38% مقارنة بالإصدارات السابقة.
كما يدعم النموذج نافذة سياقية بطول 128 ألف رمز (قابلة للتمديد إلى مليون رمز في بعض التطبيقات)، مما يمكنه من معالجة مستندات طويلة مثل الأوراق البحثية والقواعد البرمجية الكاملة دون فقدان السياق.
من الناحية التقنية، يعتمد النموذج على هندسة “خليط الخبراء” (Mixture-of-Experts) مع تحسينات في أنظمة الانتباه المتعددة (Multi-head Latent Attention) والتدريب بدقة FP8 المختلطة، مما يقلل استخدام الذاكرة بنسبة تصل إلى 75% مع الحفاظ على الدقة.
كما قدم الفريق استراتيجية جديدة لتحقيق التوازن في التحميل دون الحاجة إلى خسائر مساعدة (auxiliary-loss-free)، مما يحسن استقرار النموذج.
التكلفة الاقتصادية للنموذج كانت مفاجأة للكثيرين، حيث بلغت تكلفة التدريب الكامل 5.58 مليون دولار فقط (باستخدام 2.788 مليون ساعة من معالجات H800)، وهي جزء بسيط من تكلفة تدريب نماذج منافسة مثل GPT-4o التي تقدر تكلفتها بأكثر من 100 مليون دولار.
هذا الانخفاض في التكلفة يعزى إلى التحسينات الخوارزمية وكفاءة البنية التحتية، بما في ذلك استخدام ذاكرة FP8 والاتصالات المثلى بين العقد في التدريب.
في التقييمات المعيارية، أظهر DeepSeek-V3.1 أداءً متميزاً في المعرفة والرياضيات والبرمجة، حيث تفوق على جميع النماذج مفتوحة المصدر وحقق نتائج قريبة من النماذج المغلقة الرائدة مثل GPT-4o وClaude-3.5-Sonnet.
في اختبار MMLU للفهم العام، سجل النموذج 88.5%، بينما حقق 90.2% في اختبار MATH-500 للرياضيات و82.6% في اختبار البرمجة HumanEval.
يأتي هذا الإطلاق في وقت تشتد فيه المنافسة بين الصين والولايات المتحدة في مجال الذكاء الاصطناعي، حيث تمكنت DeepSeek من تحقيق قفزة تقنية رغم القيود الأمريكية على تصدير الرقائق المتطورة، وذلك بالاعتماد على تحسين البرمجيات والخوارزميات لتعويض نقص العتاد.
النموذج متاح بشكل مفتوح المصدر تحت ترخيص MIT، مما يسمح للمطورين والشركات حول العالم باستخدامه وتطويره.
هذا التقدم يضع DeepSeek في موقع تنافسي قوي أمام عمالقة التكنولوجيا الأمريكيين، ويمثل نموذجاً لكيفية استخدام الابتكار في البرمجيات لتعويض التحديات في مجال العتاد، مما قد يعيد تشكيل مشهد الذكاء الاصطناعي العالمي في السنوات المقبلة.